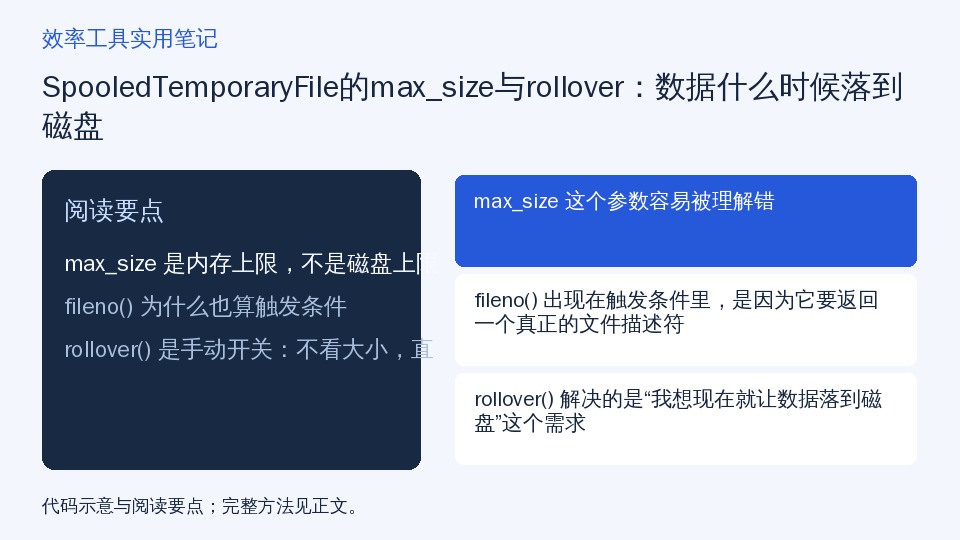
本文要点
max_size 这个参数容易被理解错
fileno() 出现在触发条件里,是因为它要返回一个真正的文件描述符
rollover() 解决的是“我想现在就让数据落到磁盘”这个需求
本文目录
先回答:两个触发条件,加一个手动开关
如果你用 SpooledTemporaryFile 暂存数据,想知道它什么时候从内存转到磁盘,答案有三个入口。
按 Python 官方 tempfile 文档的说明,这个类的行为与 TemporaryFile() 完全一致,区别在于:数据会先在内存中暂存(spooled in memory),直到文件大小超过 max_size,或者文件的 fileno() 方法被调用,此时内容才被写入磁盘,之后的操作就和 TemporaryFile() 一样了。
文档还写明,这个对象额外带一个 rollover() 方法,它会让文件“无论大小”都转为磁盘文件。
所以判断顺序可以这样定:
1. 写入的数据量有没有超过 max_size?超过就落盘。
2. 有没有调用 fileno()?调用了就落盘。
3. 有没有主动调用 rollover()?调用了就落盘,不看大小。
三个条件任意一个成立,数据就从内存转到磁盘。本文只讲这三个触发条件,不讲性能调优。
一个前提:下面所有示例都是自建的练习脚本,只操作练习目录,不碰你正在用的文件。动手前建议在练习目录里新建脚本,例如 exercise/spool_demo.py。
max_size 是内存上限,不是磁盘上限
max_size 这个参数容易被理解错。它限制的是“数据在内存里能待多久”,不是“文件最大能有多大”。
按文档的表述,数据在内存中暂存,直到文件大小超过 max_size。也就是说,max_size 是内存阶段的容量阈值。一旦写入量越过这条线,内容就被写到磁盘,之后继续写多少都不再受这个值约束——因为此时它已经是一个磁盘文件了。
文档给出的默认值是 max_size=0。这一点值得单独记一笔:默认值不是某个较大的数字,而是 0。所以如果你不显式传 max_size,任何一次写入都会立刻超过它,数据基本不会在内存里停留。
一个自建示例(练习数据,不是对真实文件的记录):
import tempfile

with tempfile.SpooledTemporaryFile(max_size=16) as f:
    f.write(b"12345678")
    print(f._file)
这里 max_size 设成 16,写入 8 个字节,没有超过上限,所以此时底层还是内存对象。文档说明,返回对象的 _file 属性要么是 io.BytesIO 或 io.TextIOWrapper(取决于二进制还是文本模式),要么是一个真正的文件对象,取决于 rollover() 有没有被调用。
需要说清的是:文档没有规定“超过”是严格大于还是大于等于,也没有给出各平台内存缓冲的具体实现细节,本文不补这些。
fileno() 为什么也算触发条件
fileno() 出现在触发条件里,是因为它要返回一个真正的文件描述符。
按文档的表述,数据在内存中暂存,直到文件大小超过 max_size,或者文件的 fileno() 方法被调用,此时内容被写入磁盘。
这句话的逻辑是:内存里的 BytesIO 对象没有操作系统层面的文件描述符,而 fileno() 的职责就是交出这个描述符。所以一旦你调用它,对象就必须先变成一个真正的磁盘文件,才能给出有效的返回值。这就是为什么调用 fileno() 会连带触发落盘,而不是只返回一个编号。
一个自建示例(练习场景,不是对真实文件的记录):
import tempfile

with tempfile.SpooledTemporaryFile(max_size=1024) as f:
    f.write(b"small")
    print(f._file)
    fd = f.fileno()
    print(f._file)
第一次打印时数据量远小于 1024,底层还是内存对象;调用 fileno() 之后再打印,底层已经变成真正的文件对象。
这里要提醒一点:文档没有说明 fileno() 在文本模式下是否同样可用、返回值在哪些平台上有什么差异,本文不替它补这些结论。如果你只是想知道“有没有落盘”,看 _file 的类型比看 fileno() 的返回值更直接。
rollover() 是手动开关:不看大小,直接落盘
rollover() 解决的是“我想现在就让数据落到磁盘”这个需求。
按文档的表述,rollover() 会让文件无论大小都转为磁盘文件。注意“regardless of its size”这个限定:它不检查当前数据量有没有超过 max_size,你调用它就执行。
它和另外两个触发条件的区别在于主动性:
- 超过 max_size 是被动的,由写入量决定。
- 调用 fileno() 是间接的,你本来可能只是想要一个描述符。
- 调用 rollover() 是直接的,你就是想让它落盘。
一个自建示例(练习数据,不是对真实文件的记录):
import tempfile

with tempfile.SpooledTemporaryFile(max_size=1024) as f:
    f.write(b"tiny")
    print(f._file)
    f.rollover()
    print(f._file)
写入量很小,本来不会触发落盘;调用 rollover() 之后,底层对象类型发生变化。
一个边界:文档只说明 rollover() 会让文件转为磁盘文件,没有说明重复调用它会怎样、也没有说明调用后原有数据如何迁移的细节,本文不补这部分。
怎么核对数据到底在内存还是磁盘
判断落盘有没有发生,最直接的办法是看 _file 属性的类型,而不是靠猜。
文档明确写了这个属性的取值:要么是 io.BytesIO 或 io.TextIOWrapper(取决于二进制还是文本模式),要么是一个真正的文件对象,取决于 rollover() 有没有被调用。
所以核对方法可以这样组织(以下为编辑整理的观察方法,不是对某个真实程序的测试记录):
1. 在写入前后分别打印 _file,比较类型有没有变。
2. 类型是 BytesIO 或 TextIOWrapper,说明还在内存阶段。
3. 类型变成真正的文件对象,说明已经落盘。
一个自建对照表(示例,不是实测数据):
| 操作 | 预期 _file 类型 |
| 写入量小于 max_size | 内存对象 |
| 写入量超过 max_size | 文件对象 |
| 调用 fileno() 后 | 文件对象 |
| 调用 rollover() 后 | 文件对象 |
需要提醒的是:_file 带下划线前缀,文档把它作为属性来描述,但它不是为日常调用设计的公开接口。用它来观察行为可以,不要把它当成稳定的编程接口去依赖。
用 with 语句时,落盘时机和清理时机是两件事
落盘和清理容易被混在一起,但它们回答的是不同问题。
落盘回答的是“数据现在存在哪里”,由 max_size、fileno()、rollover() 三个条件决定。清理回答的是“这个临时文件什么时候消失”,由上下文管理器或对象销毁决定。
文档说明,TemporaryFile、NamedTemporaryFile、TemporaryDirectory 和 SpooledTemporaryFile 都是提供自动清理、可作为上下文管理器使用的高层接口。对 SpooledTemporaryFile 来说,它“与 TemporaryFile() 完全一致”,所以同样遵循这套清理规则。
也就是说,即使数据已经落到磁盘,退出 with 语句时它仍然会被清理掉。落盘不等于留下文件。
一个自建示例(练习场景,不是对真实文件的记录):
import tempfile

with tempfile.SpooledTemporaryFile(max_size=8) as f:
    f.write(b"0123456789")
    print(f._file)
写入 10 个字节,超过 max_size=8,触发落盘。退出 with 之后,这个临时文件按高层接口的规则被清理。
一个边界:文档没有说明落盘后文件在文件系统中的可见性,也没有给出具体路径,本文不补这些内容,也不建议你去按路径查找它。
使用限制与参考资料
本文只讲 SpooledTemporaryFile 在内存与磁盘之间切换的三个触发条件,以及 rollover() 的作用。以下几点是资料没有支持、因此本文没有展开的内容:
- 没有给出不同 max_size 取值下的性能差异,也没有建议取多大合适。
- 没有说明落盘后文件的具体位置和命名规则。
- 没有说明文本模式与二进制模式下触发行为是否有差异。
- 没有说明多线程或多进程场景下的行为。
操作提醒:本文所有示例都只操作练习目录里的自建脚本,不读写你正在使用的文件。运行前建议在练习目录里新建文件,例如 exercise/spool_demo.py,不要拿重要数据直接试。
事实来源:Python 官方 tempfile 模块文档,https://docs.python.org/3/library/tempfile.html
观看知识要点视频 18 秒
18秒无旁白要点导览,文字来自已审核正文;完整步骤、条件及参考资料见下方。
参考资料
以下原始资料提供本文依据;请结合日期、适用条件和产品说明查阅。
请结合原始资料的适用条件阅读。
返回文件整理 →